前回、撮るところは VisionKit に任せた、と書きました。次は、その先 ── 撮った名刺を「読んで、項目に振り分ける」ところです。読むのは Vision の文字認識。問題は、その後ろの「振り分け」のほうにありました。
振り分けるのは、AI
文字認識が返してくるのは、名刺に印刷された文字の山です。「山田太郎」「株式会社○○」「営業部 部長」「03-…」「…@…」── これを、氏名・会社・部署・役職・電話・メール・住所に分けないと、連絡先にはなりません。
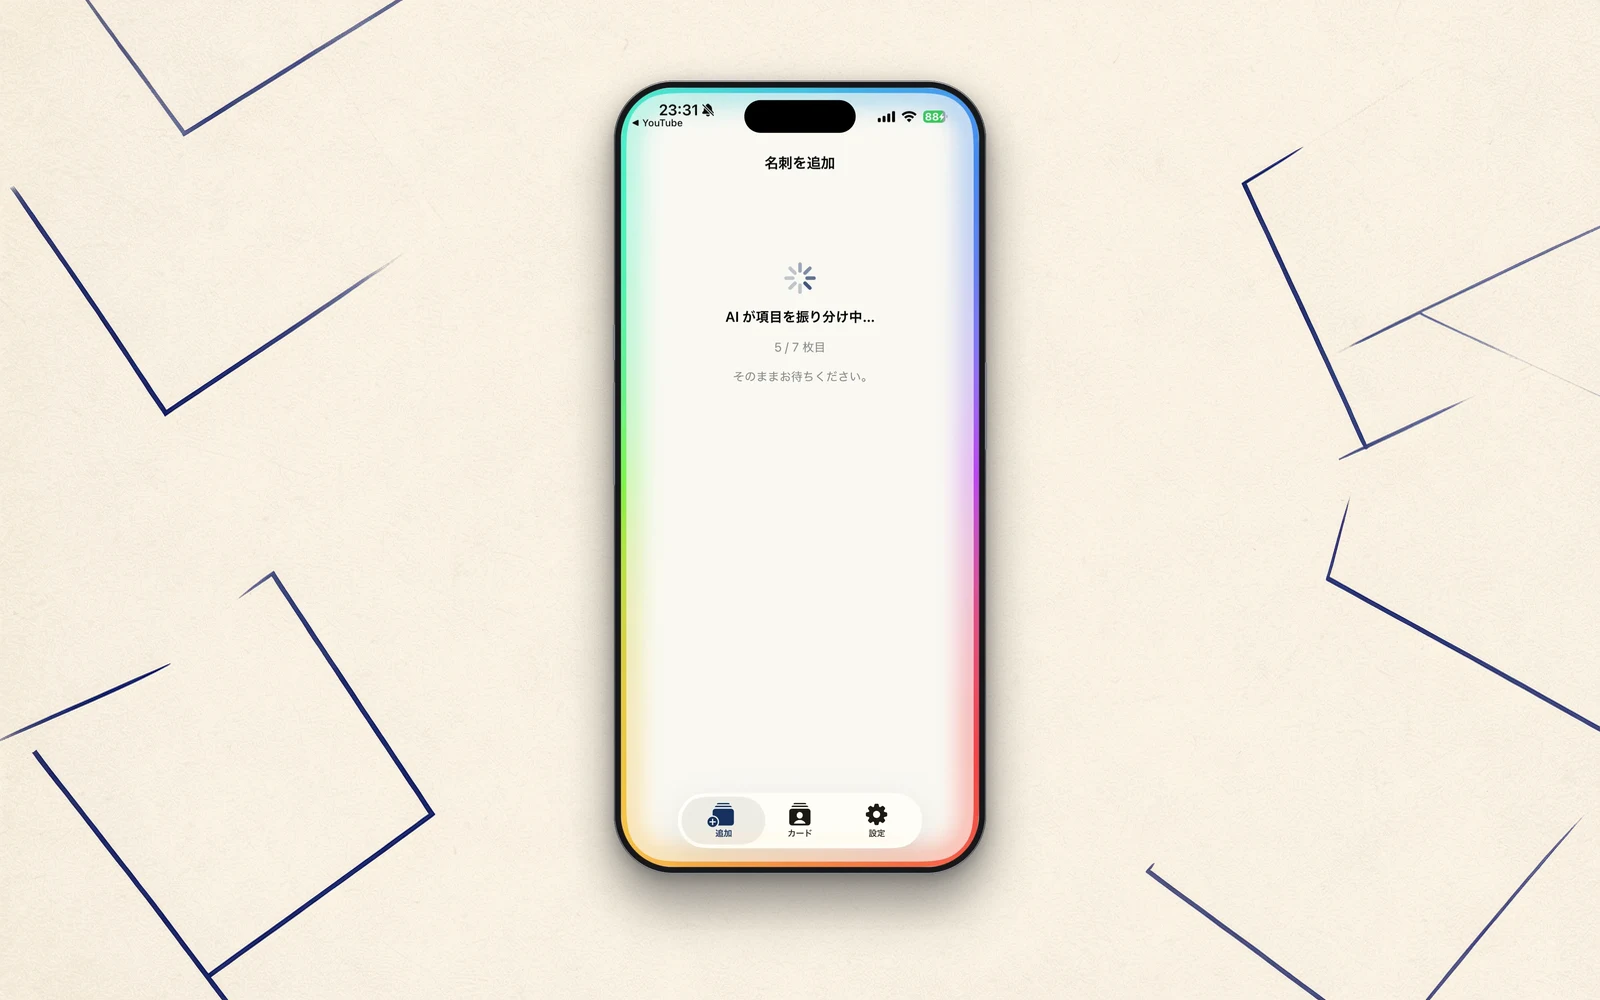
この振り分けを、STIL.BIZ は Apple Intelligence の Foundation Models(iPhone の中で動く言語モデル)にやらせています。文字の塊を渡すと、どれが名前で、どれが会社で、どれが役職か、を読み取って整えてくれる。きれいに決まると、気持ちのいい仕組みです。
でも、そこには線がある
ところが、この Foundation Models には、はっきりした線があります。Apple Intelligence に対応した端末でしか動かないのです。
最初、私は「じゃあ、対応端末だけのアプリにしよう」と考えました。そのほうが、作りはずっとシンプルになります。でも、対応する端末を調べていくうちに、手が止まりました。その線で切ってしまうと、届かない人が、かなり多い。名刺をいちばん使うのは、必ずしも最新の iPhone を持っている人とは限りません。むしろ、長く同じ端末を使っている人のほうが、名刺は溜まっている。
AI がない側にも、同じ体験を
そこで、決めました。AI が動かない端末には、AI を使わない振り分けを、自分で書く。
レイアウト ── 文字の大きさと、紙のどこにあるか ── と、キーワードの辞書を組み合わせて、氏名・会社・役職・部署・住所を推定する仕組みです。CardHeuristicParser と名づけました。日本の名刺は、型がだいたい決まっています。いちばん大きい文字はたいてい名前、その近くにあるのは会社、@ を含む文字列はメール。AI でなくても、ルールで、実用になる精度が出せる。もし間違えても、確認画面で直せます。
ライブラリは、一つも積まなかった
ここで効いたのが、容量でした。ふつう、AI の代わりを自前で持とうとすると、機械学習のモデルやライブラリを抱え込んで、アプリが重くなります。容量を理由に「やっぱりやめておこう」となりがちな場面です。
でも STIL.BIZ は、撮影(VisionKit)も、文字認識(Vision)も、AI の振り分け(Foundation Models)も、全部 OS が標準で持っている力を借りているだけで、アプリにモデルを同梱していません。だから、ルールベースの振り分けも、書くのは Swift のコードだけ。増えた容量は、ゼロでした。あきらめる理由は、どこにもなかったのです。
線の、向こう側にも
こうして、撮影と文字認識は全機種で同じになりました。違うのは振り分けの中身だけ ── 新しい端末では AI、それ以外ではルールベース。けれど、使う人から見れば、どの iPhone でも、名刺が連絡先になる。
AI を使えることが、アプリを使える条件にならないようにする。これは、STIL.BIZ で、いちばん作ってよかったと思っている部分です。新しいものを追いかけるのは、楽しい。でも、追いかけられない側にも、ちゃんと手を伸ばしておく。線の向こうにも、人はいます。
次回
仕組みの話が続いたので、次は現場の話を。連続でスキャンしていると、五枚目あたりで画面が固まる ── その原因を追ううちに、仕様そのものを作り替えることになった話をします。
STIL.BIZ は App Store で公開しています。