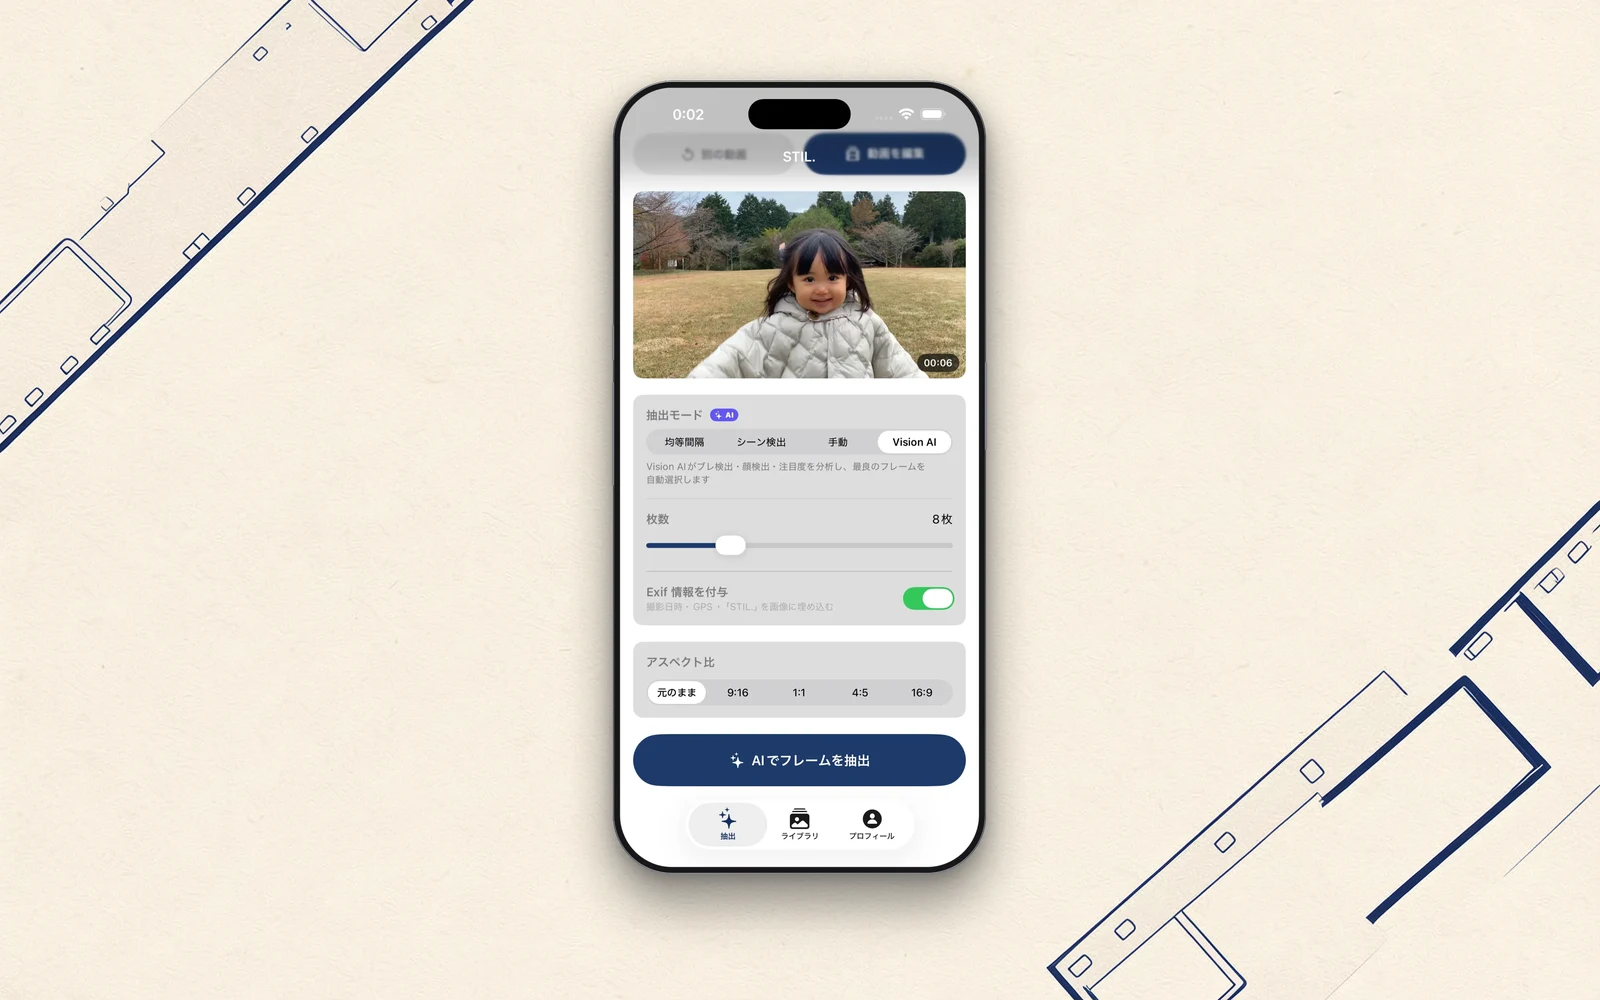
STIL. の中心にあるのは、「動画から、良いコマだけを自動で選ぶ」機能です。今日はその中身を、なるべく専門用語に頼らずにのぞいてみます。
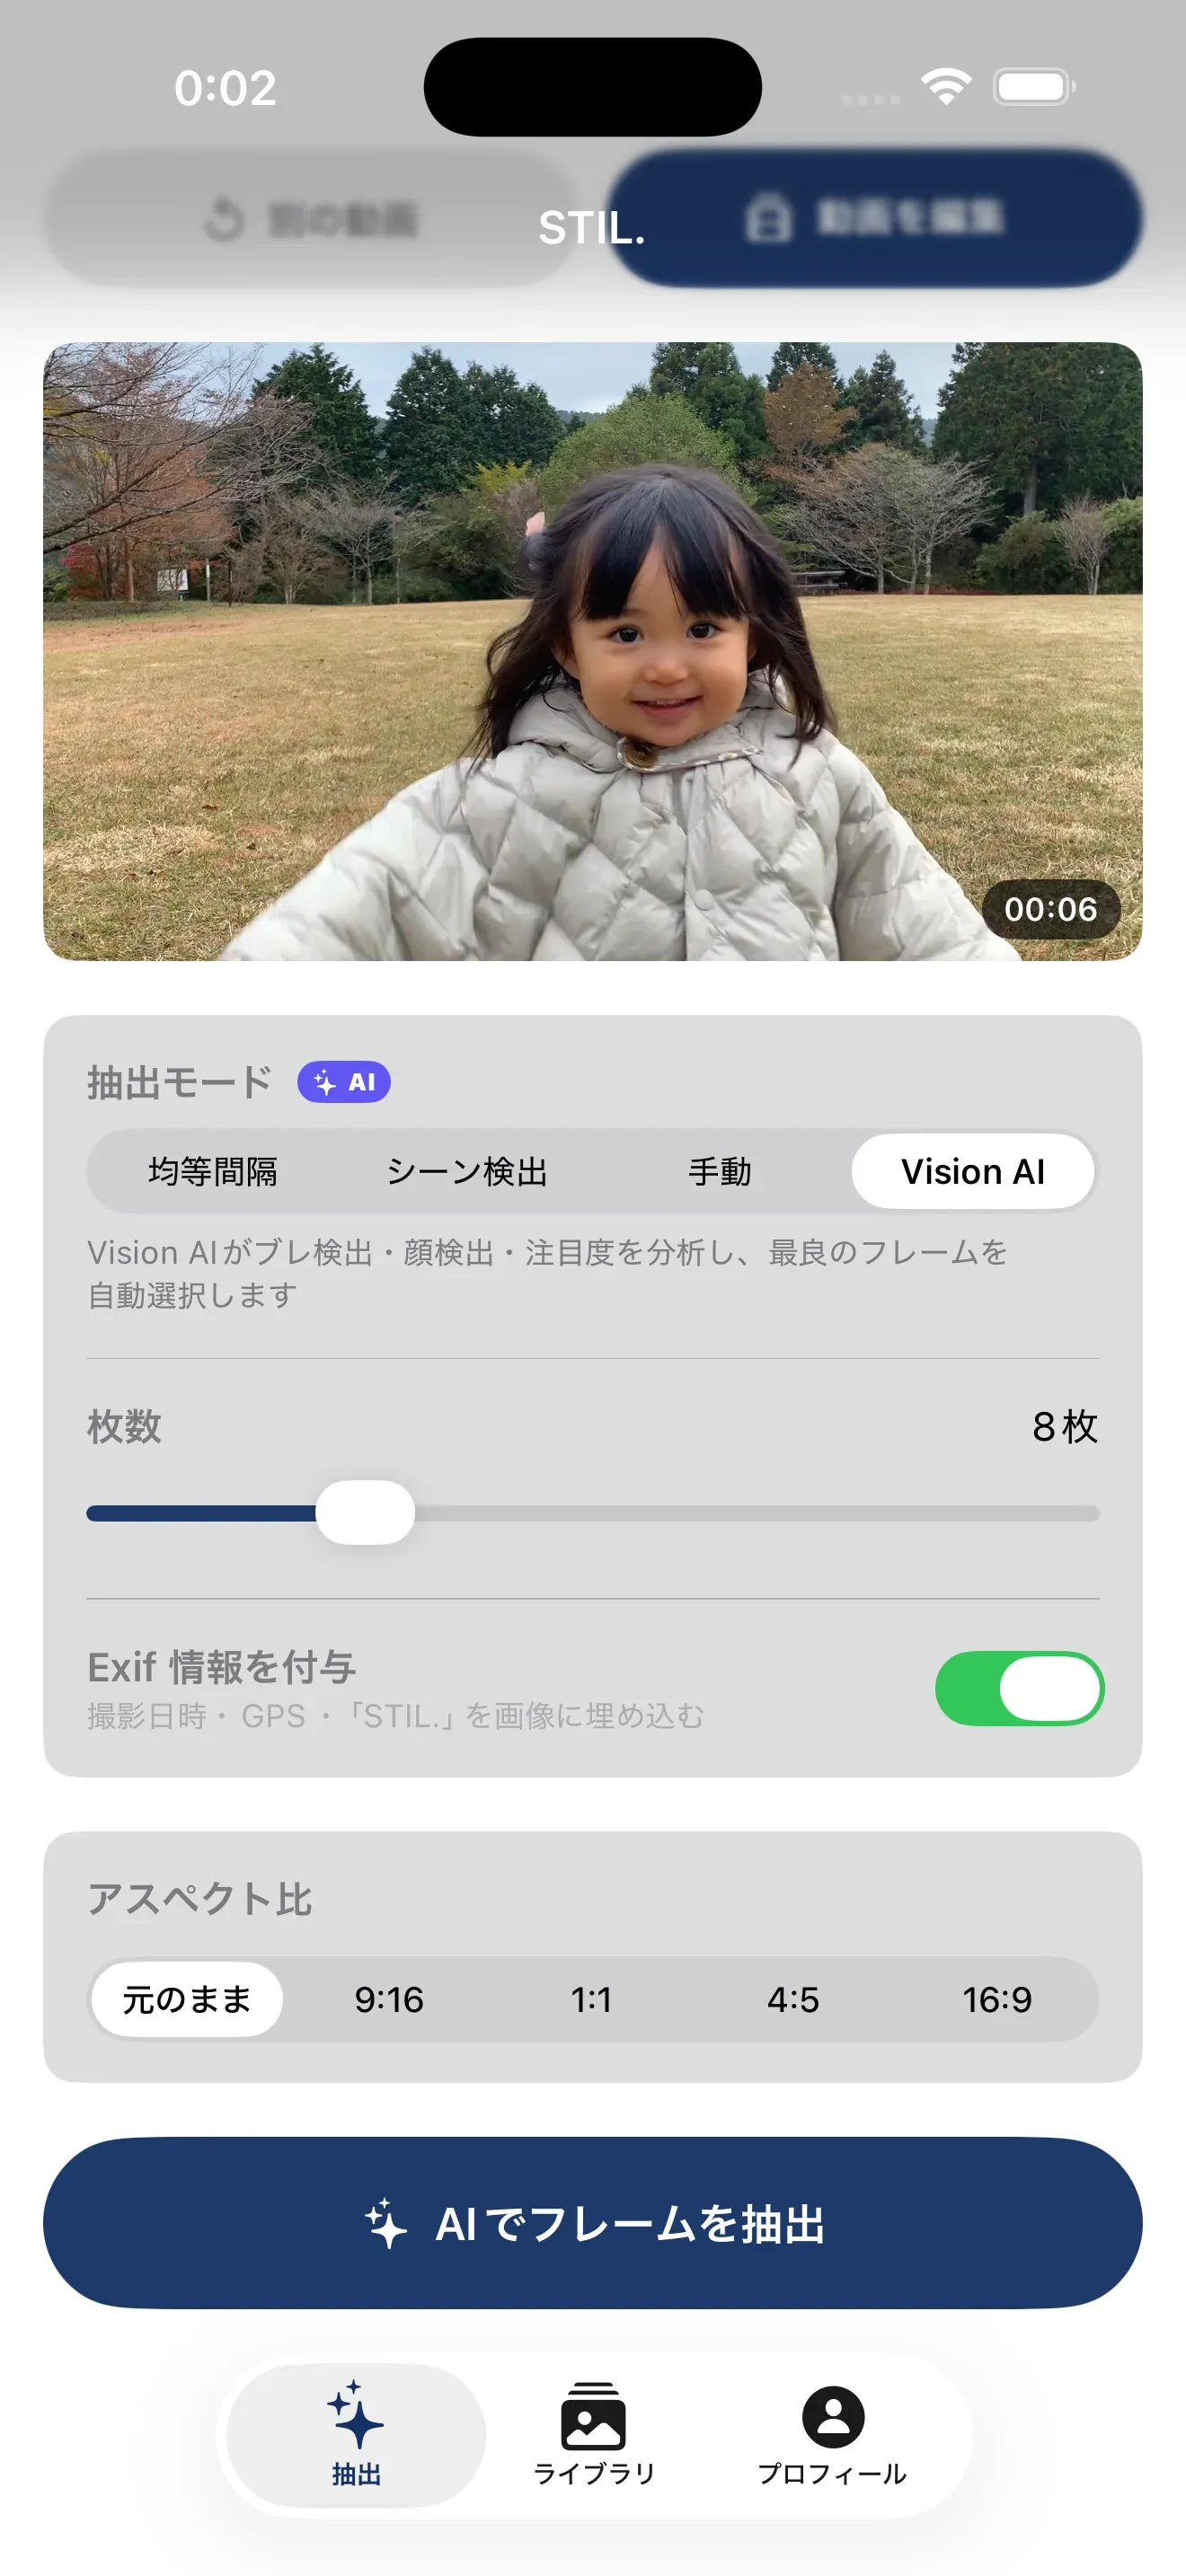
10 秒の動画でも、その中には数百枚のコマがあります。人間が全部を見比べるのは大変です。そこで STIL. は、Apple の Vision Framework と独自のスコアリングで、一枚ずつに点数をつけて、上位だけを取り出します。
三つの目で測る
「良いフレーム」と一口に言っても、何が良いのかを数字にしないと、機械は選べません。STIL. は、主に三つの目で各コマを測っています。
- ブレていないか ── 画像の細部のくっきり具合を、ラプラシアン分散という計算で測ります。ピンボケや手ブレのコマは、ここで低い点になります。
- 顔が良く写っているか ──
VNDetectFaceRectanglesで顔を検出します。人物のシーンでは、顔がちゃんと写っているコマを優先します。 - 見どころがあるか ──
VNGenerateAttentionBasedSaliencyで、画像の「思わず目が行く場所」のマップを作ります。主役がはっきりしているコマほど高くなります。
この三つを 重みづけして合成し、一枚ぶんの点数にします。シャープさを軸に、顔と注目度を足していく。目を閉じた瞬間やブレたコマは自然に沈み、表情と構図が決まったコマが浮かび上がる ── そういう設計です。
三段階で、軽く速く
全部のコマを高解像度で解析すると、重くて時間がかかります。STIL. は、この仕事を三段階に分けています。
- 第 1 段階:候補のコマを、小さなサイズ(低解像度)で素早くスコアリングする
- 第 2 段階:点数を正規化して、上位を時系列順に選ぶ
- 第 3 段階:選ばれたコマ「だけ」を、高解像度で取り出す
つまり、たくさんのコマは軽く見て、本命だけを丁寧に仕上げる。端末の中だけで完結させるために、無駄な重さを削る工夫です。これも、サーバーに送れば楽になるところを、あえて送らずに済ませるための設計でした。
「似たコマばかり」を避ける
最初のバージョンでは、点数だけで選ぶと、いちばん良い瞬間の前後の、よく似たコマばかりが並んでしまうことがありました。連写の中の数枚を見せられているような感じです。
そこで v1.2 では、選び方を見直しました。抽出スタイル(人物・動き・風景など)ごとに別々のものさしで測るようにして、動画の時間帯ごとに均等に選ぶようにした。人物スタイルでは、人が写っていないコマは外す。結果として、スタイルを変えると、選ばれる一枚も明確に変わるようになりました。
「自動」の裏側には、判断がある
「AI が自動で選ぶ」と書くと一行ですが、その一行の裏には、「何を良しとするか」という小さな判断がいくつも積もっています。ブレを嫌うのか、顔を優先するのか、見どころを重く見るのか。そのものさしを決めるのが、作る側の仕事でした。
派手な仕掛けではありません。地道な計算の積み重ねです。でも、その積み重ねの先で「あ、この一枚」と思ってもらえたら、私としては大成功です。
次回は、その STIL. を世に出すまでの、いちばん泥くさい話を。App Store に 3 回落ちて、4 回目で通るまでの記録です。
STIL. のことは stil.photo、本体は App Store に置いてあります。