前回、声はぜんぶ手強かった、と書きました。今日は、その中でいちばん驚いた話です。
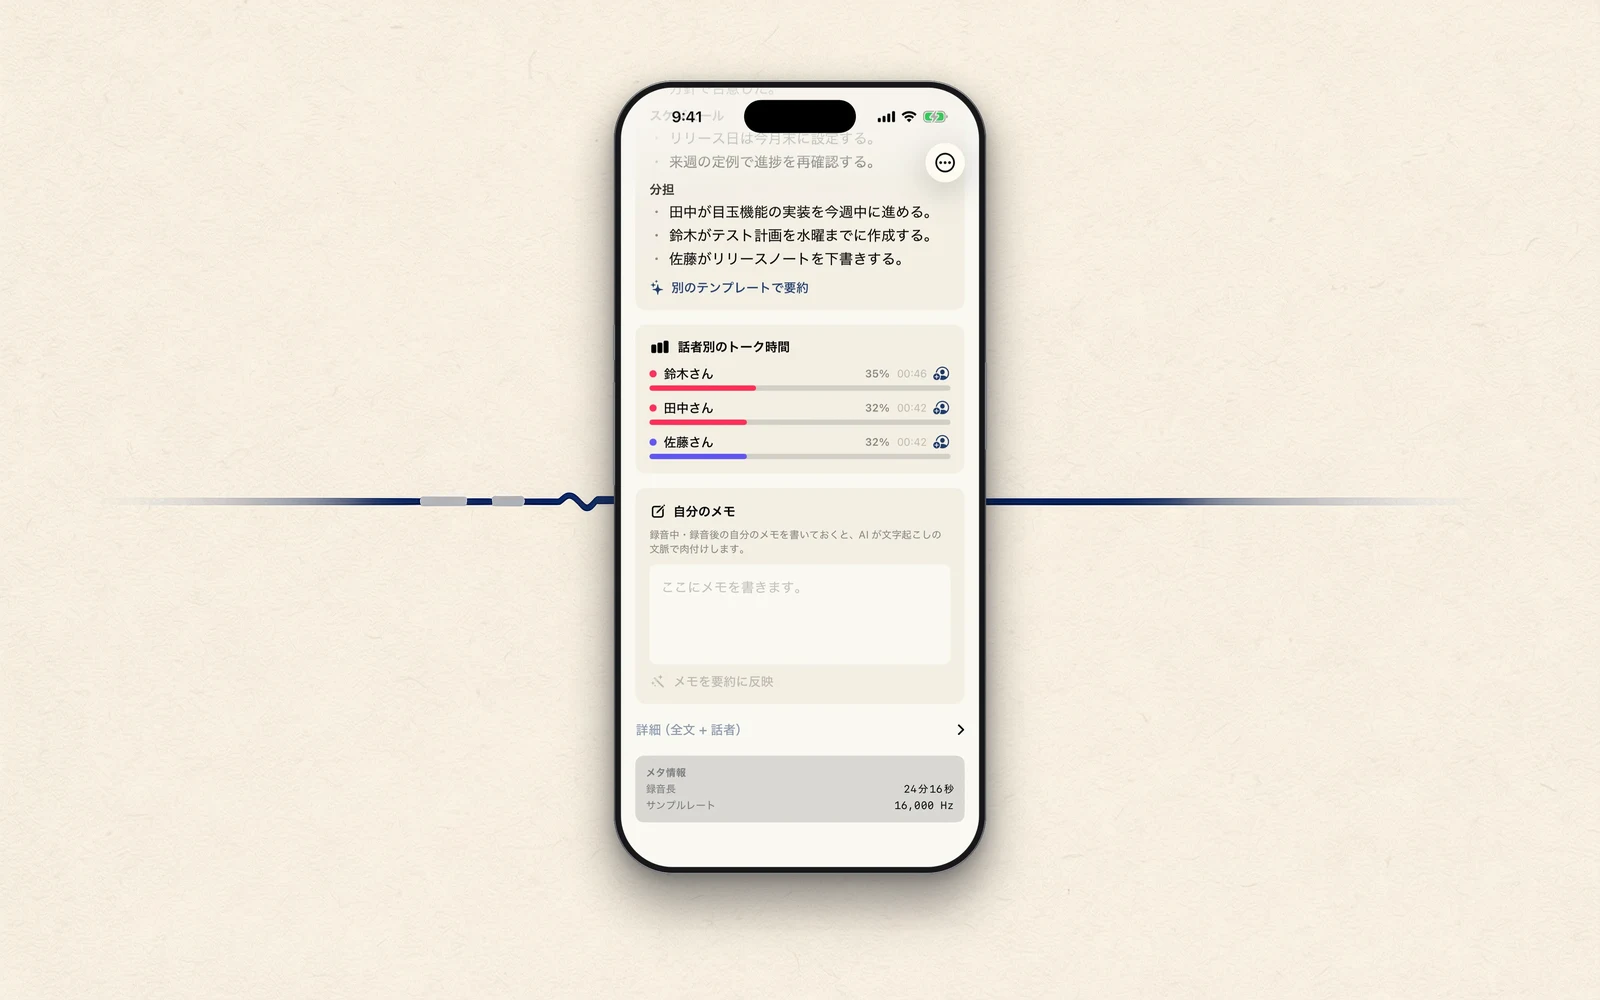
STIL.NOTE には、あらかじめ自分や家族の声を登録しておくと、録音の中のその人の発言に、名前が付く機能があります。「田中さん:」のように。その機能が、おかしかった。
知らない声に、知っている名前が付いた
現象は、こうです。登録していない人だけが話している録音に、登録した人の名前が付く。
試しに「アリス」という名前で声を登録して、アリスがひとことも話していない録音を処理してみると、全編が「アリス」の発言になりました。誰の声でも、です。声を似せる必要すらありません。
照合が、存在しなかった
話者の聞き分けには、オンデバイスの話者分離モデルを使っています。調べていって分かったのは、こういうことでした。
このモデルは、「声が切り替わった」ことを見つけるのは得意です。録音の中の話者を、席 1、席 2、と席に分けていく。けれど、「その声が誰か」を確かめる仕組みを、そもそも持っていませんでした。
では、声の登録とは何だったのか。登録した音声をモデルに流して、いちばん強く反応した席に、名前の文字列を貼る ── それだけでした。声そのものと名前を結びつける照合は、どこにもない。名前は、席番号への、貼り紙だったのです。
しかも、新しい録音を処理するとき、席の中身(それまでの声の記憶)は空にリセットされるのに、貼り紙だけが残る作りになっていました。このモデルは、先に話した人から順に席を割り当てます。つまり、処理のしかたによっては、新しい録音で最初に話した人が、誰であっても、その名前をもらう。アリスの正体は、これでした。
もっと悪いことに
さらに調べると、逆のことも分かりました。ふつうに録音するときの経路では、録音開始時に貼り紙ごと剥がされるので、登録した名前はそもそも一度も表示されない。
つまりこの機能は、正しく識別されることは構造的になく、誤って識別されることだけがある、という状態でした。動いているように見えていたものが、最初から動いていなかった。バグの中でも、いちばん背筋の冷えるやつです。
「分ける」と「決める」を、分けた
作り直しの方針は、仕事を二つに割ることでした。
分けるのは、いままでどおり話者分離モデルの仕事です。いつ、どの席の人が話したか。ただし席は無名のまま、「Speaker 1」「Speaker 2」として。
決めるのは、別の仕組みの仕事にしました。登録した声と、録音の中の声から、それぞれ「声の特徴」を数値の並びとして取り出して、その距離を測る。実際に測ってみると、本人の声どうしの距離は 0.06、別人だと 0.98。あいだには、広い川が流れていました。その川に線を引いて、線を越えて近いときだけ、名前を付ける。届かなければ、Speaker 2 のままにする。
照合のためのモデルをもうひとつアプリに同梱することになりました(約 29 MB)。それでも、実行時に何かをダウンロードしたり、声を外に送ったりはしません。すべて、この iPhone の中で、は変わらずです。
分からないときは、分からないと言う
直してみて思ったのは、機械に名前を言わせることより、機械に「分からない」と言わせることのほうが、ずっと大事だった、ということです。
前の作りは、確かめもせずに、知っている名前を言ってしまう作りでした。いまの作りは、確信が持てないとき、Speaker 2 という正直な答えを返します。愛想はないけれど、嘘はない。記録を扱う道具は、そちらであるべきだと思っています。
次回
じつは、同じことが要約でも起きていました。聞いた以上のことを、言ってしまう。次は、AI が「はい。」の一言から、ありもしない会議を作ってしまった話です。
STIL.NOTE は App Store で公開しています。